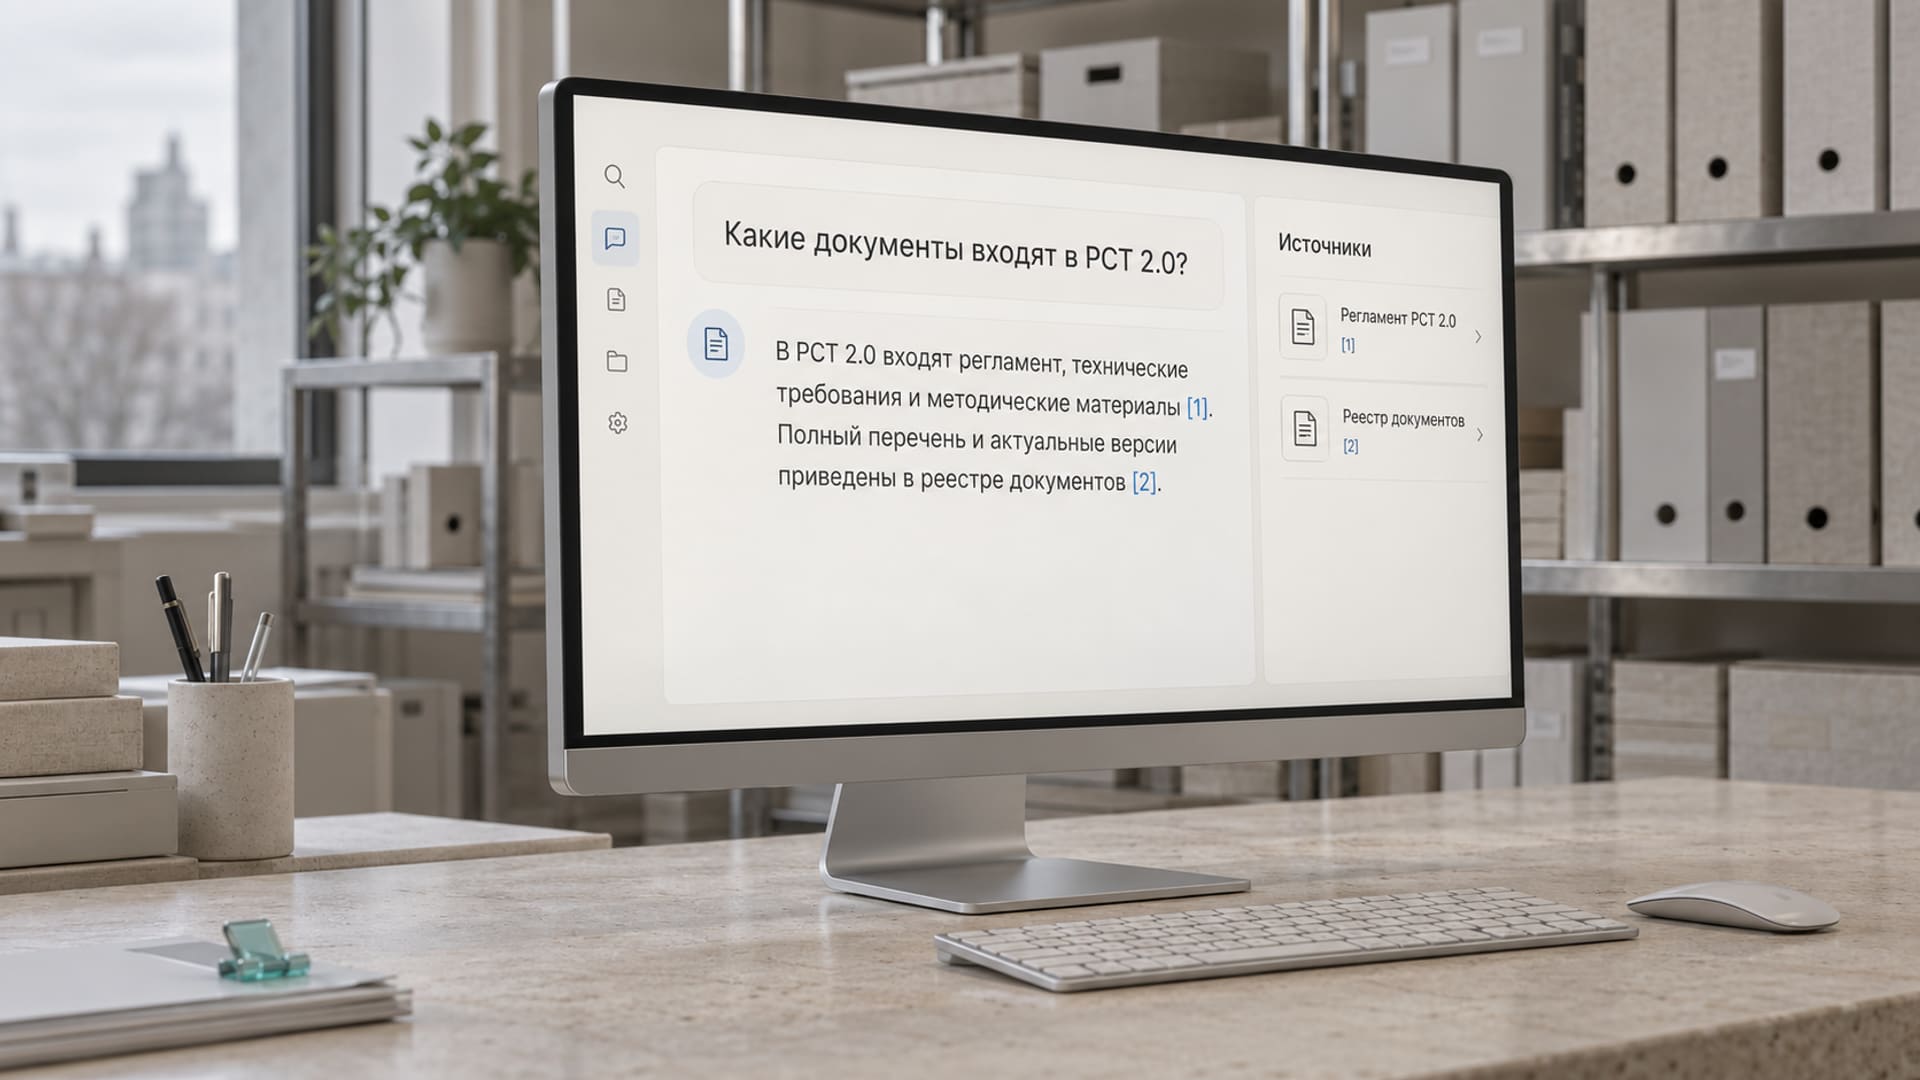
KI-System · Öffentlicher Sektor: Normung und Messwesen
RAG-Wissensdatenbank und KI-Strategien
Rosstandart · 2025 · KI-System · Python 3.11, LangChain
Eine RAG-Demo auf Basis von Dokumenten von Rosstandart und des Projekts „RST 2.0“, eine Analyse von fünf nachgeordneten Organisationen und eine Spezifikation zur Extraktion von Anforderungen aus GOST-Normen
Zwei zusammenhängende Arbeitsstränge. Der erste ist ein Demo-RAG-System auf Basis von Dokumenten von Rosstandart und des Digitalisierungsprojekts „RST 2.0“ (15 Dokumente, 954 Chunks): Antworten in natürlicher Sprache mit Links zu den Quellen; es durchlief drei Iterationen (lokales FAISS, dann inkrementelle Verwaltung der Vektor-DB, dann Migration zu Milvus) und ein Code-Review. Der zweite ist ein Analysepaket zu fünf nachgeordneten Organisationen (30+ Dokumente, rund 600 Seiten) mit Strategien zur KI-Optimierung sowie eine Prüfung der technischen Spezifikation eines Normungsinstituts für ein System, das maschinenlesbare Anforderungen aus GOST-Normen extrahiert und an die Systeme des Kunden übergibt.
Die Aufgabe
Verstreute Informationen über die Behörde und ihre nachgeordneten Organisationen und der Bedarf an einer KI-Einführungsstrategie; für das Normungsinstitut die Umwandlung von Regelwerken in Anforderungen, die sich maschinell verarbeiten und in KI-, MDM- und MES-Systeme integrieren lassen.
Was drinsteckt
- RAG auf Claude 4.5 Sonnet (über OpenRouter) mit mehrsprachigen Embeddings paraphrase-multilingual-MiniLM-L12-v2; Quellenangaben in jeder Antwort
- Edition A: inkrementelles Hinzufügen und Entfernen von Dateien in der Vektor-DB ohne vollständige Neuindizierung, Verwaltung per CLI und Integritätsprüfung
- Edition B: Milvus statt FAISS, Schutz vor Prompt Injection und DoS, ein Timeout von 60 Sekunden für alle Modellanfragen
- Analysepaket für jede der 5 Organisationen: ein umfassender Bericht, eine KI-Strategie (8 Handlungsfelder, eine Roadmap 2026–2028), eine Kurzübersicht mit SWOT, ein Arbeitsbericht
- Die Spezifikation des Normungsinstituts: ein Ontologiemodell (OWL 2, SHACL, Apache Jena), Extraktion von Entitäten und Relationen (ruRoBERTa-large), eine REST API auf Java Spring Boot, Konverter für AI/MDM/MES, eine Phase „autonomer Start“
Maschinelle Übersetzung – das Lektorat läuft.